
 ">WeChat
I. DOMAINES DE SÉCURITÉ
Le périmètre du pare-feu comprend une zone de sécurité et un espace sécurisé.
Zone de sécurité
Dans le pare-feu, une zone de sécurité (zone de sécurité), appelée zone (zone), est une combinaison d’une ou plusieurs interfaces qui contiennent les mêmes attributs de sécurité pour les utilisateurs.
L’équipement considère que les flux de données dans la même zone de sécurité sont crédibles et n’exigent aucune stratégie de sécurité. Ce n’est qu’en cas de flux de données entre différentes zones de sécurité que des contrôles de sécurité seront déclenchés contre les pare-feu et les stratégies de sécurité correspondantes mises en œuvre.
Zone sécurisée.
Deux zones de sécurité constituent une zone sécurisée (Interzone) et ont une vue séparée sur l’espace de sécurité, la plupart étant configurées sous la vue sur l’espace sécurisé.
Par exemple, lorsqu’une zone de sécurité est configurée Zone1 et Zone2, dans la vue sécurisée interdomaines de Zone1 et Zone2, vous pouvez configurer les filtres de paquets ACL pour indiquer que des filtres de paquets ACL sont mis en place pour les flux de données entre Zone1 et Zone2.
Après la fonction de pare-feu électrique dans une zone sécurisée, lorsque les utilisateurs hautement prioritaires accèdent à des zones peu prioritaires, le pare-feu enregistre les informations sur l’IP, VPN et ainsi de suite, générant un organigramme. Lorsque le message revient, l’appareil regarde des informations telles que IP, VPN et ainsi de suite, parce qu’il contient des messages qui envoient des messages, il y a des tables auxquelles passe le rapport de retour. Les utilisateurs prioritaires ont par défaut été autorisés à accéder à la zone d’utilisation prioritaire. Ainsi, l’intranet est défini comme une zone prioritaire, l’extranet est défini comme une zone prioritaire inférieure, l’initié a un accès actif au réseau externe, tandis que les utilisateurs hors ligne ne peuvent pas y accéder.
Avantages des pare-feu basés sur des zones sécurisées
La configuration stratégique des commutateurs/routeurs traditionnels est généralement construite autour de l’interface entrée-entrée, à partir de laquelle le pare-feu a progressivement évolué pour s’éloigner d’un rôle qui ne relie que les réseaux externes et intranet, avec un modèle Intranet/extranet/DMZ (Démilitarized Zone) et se déplaçant dans le sens de fournir une forte densité de port. Dans cet environnement réseau, la configuration tactique traditionnelle basée sur l’interface impose un énorme fardeau aux administrateurs de réseau, et les charges de travail de maintenance des stratégies de sécurité se sont multipliées, augmentant également la probabilité que le déploiement introduise des risques pour la sécurité.
Outre les configurations complexes de la politique de sécurité basées sur l ‘ interface, certains pare-feu prennent en charge la configuration stratégique globale. L ‘ inconvénient d ‘ une configuration de stratégie globale est qu ‘ elle doit être configurée de manière épaisse, qu ‘ un appareil ne peut être équipé que de la même stratégie de sécurité et qu ‘ il ne répond pas aux exigences des utilisateurs pour différentes stratégies de sécurité dans différents domaines ou interfaces de sûreté, qui ont des limites évidentes d ‘ utilisation.
Les pare-feu basés sur des zones sécurisées permettent de mettre en place une configuration basée sur les zones de sécurité, toutes les stratégies de détection d’attaque étant déployées dans la zone de sécurité, qui sont simples et souples, à la fois pour réduire le fardeau des administrateurs de réseau et pour satisfaire aux exigences relatives aux différentes stratégies de préparation aux frappes pour une zone de sécurité dans des conditions complexes de regroupement.
II. MÉTHODOLOGIE DES FEUILLES
Afin d’accroître la flexibilité du réseau pare-feu, les équipements ne définissent plus les modes de fonctionnement pour l’ensemble du dispositif mais plutôt les modes de travail des interfaces, qui sont les suivants:
Mode itinéraire:Si l’interface de l’appareil a une adresse IP qui est connectée à l’extérieur par trois couches, elle est considérée comme fonctionnant en mode route.
Mode transparent:Si l’interface de l’appareil n’a pas d’adresse IP pour se connecter par une connexion externe à deux niveaux, il est considéré que l’interface fonctionne en mode transparent.
Si l’appareil a à la fois une interface fonctionnant en mode route (l’interface a une adresse IP) et une interface fonctionnant en mode transparence (l’interface n’a pas d’adresse IP), il est considéré que l’appareil fonctionne dansMode mixteBaissez-vous.
1. Mode itinéraire
Lorsque l’équipement est situé entre un réseau interne et un réseau externe, chacune des adresses IP des différents segments du réseau est configurée pour les interfaces avec un réseau interne ou un réseau externe, et la structure de punch réseau originale est reprogrammée.
Comme le montre le graphique, deux zones de sécurité sont prévues : les régions Trust et Untrust, l’interface régionale Trust pour les équipements est liée au réseau interne de l’entreprise et l’interface régionale Untrust est connectée au réseau externe.
Notez que l’interface régionale Trust et l’interface régionale Untrust sont dans deux sous-réseaux différents.
Carte réseau du Groupe Mode Route
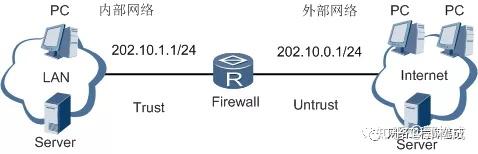
Lorsque les messages sont transmis entre des interfaces dans des zones de trois étages, le routeur est fouillé en fonction de l’adresse IP du message. L’appareil est montré comme un routeur. Contrairement aux routeurs, cependant, le message IP transmis par l’appareil nécessite un traitement pertinent, comme le filtrage et la vérification des tables ou des règles ACL pour déterminer s’il est autorisé à passer.
Lorsque vous utilisez le mode route, vous pouvez compléter les filtres ACL (access control list) et les filtres dynamiques ASPF. Cependant, le mode route nécessite des modifications aux structures de saut en réseau, comme les changements de passerelle pour les utilisateurs internes du réseau, les changements de configuration de route, etc. Avant que le réseau soit réaménagé, des compromis devraient être faits.
2. Modèle de transparence
Si l’équipement fonctionne en mode transparent, il est possible d’éviter les modifications de la structure étendue. À ce stade, l’appareil est complètement transparent pour les utilisateurs du sous-réseau qui ne le sentent pas.
Le mode de regroupement typique du modèle de transparence des équipements est montré dans la figure. L’interface régionale Trust pour les appareils est connectée au réseau interne de l’entreprise, et l’interface régionale Untrust est liée au réseau externe. Notez que l’interface régionale Trust et l’interface régionale Untrust doivent être situés dans le même sous-net.
Réseautage en mode transparent
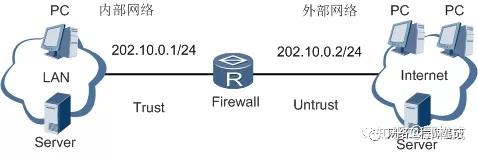
Lorsque vous utilisez un modèle transparent, il suffit d’insérer des dispositifs comme le pont dans le réseau sans changer de configuration existante. Les messages IP sont également filtrés et les utilisateurs internes du réseau restent protégés par des pare-feu.
Diagramme du mode transparence
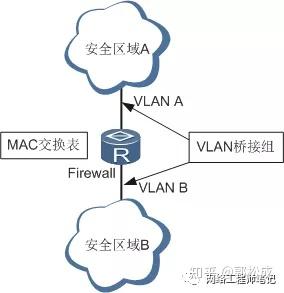
Comme le montre la figure, les zones de sécurité A et B sont reliées aux zones de sécurité A et VLAN B sur une interface interactive de données dans la même grille. Les interfaces des zones de sécurité A et B sont jointes par une équipe de passerelle composée respectivement de VLAN A et VLAN B et doivent être jointes à une unité de pont composée de VLAN A et VLAN B. Lorsque le pare-feu transmet des messages entre ces deux modes transparents, il faut d’abord effectuer un pont VLAN, les convertir en VLAN, puis trouver une interface basée sur les adresses MAC dans le message. Cependant, contrairement au pont, l’équipement doit être envoyé au niveau supérieur pour filtrage, etc., par l’examen des listes de sessions ou des règles ACL pour déterminer si le message est autorisé à passer. De plus, le pare-feu devra effectuer d’autres vérifications de prévention des attaques.
Remarque:
Exige que deux tâches soient entrées dans une interface VLAN différente en mode transparent et interactive avec des données; en même temps, les deux interfaces doivent être ajoutées au même groupe de ponts VLAN et à une seule équipe de ponts.
L’appareil effectue l’apprentissage de l’adresse MAC sur l’interface du mode transparence et une transmission de deuxième niveau en vérifiant les tables MAC lors de la transmission des messages entre les modes transparents.
3. Mode de mélange d ‘ équipements
Si l’appareil fonctionne à la fois sur une interface en mode route (l’interface a une adresse IP) et une interface en mode transparence (l’interface n’a pas d’adresse IP), il est considéré comme fonctionnant en mode hybride.
Graphique net du groupe en mode mixte
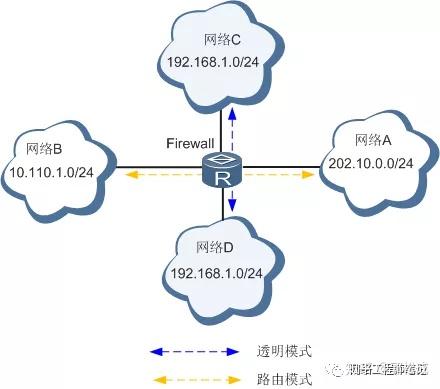
Les réseaux A et B sont des liens différents, l’interface entre les appareils et le réseau A et B est une interface à trois niveaux qui relie les messages entre A et B par route; les réseaux C et D sont les mêmes grilles, l’interface entre les appareils et le réseau C et D est une interface à deux niveaux, et les ponts VLAN et les relais de deuxième niveau aux messages entre C et D sont effectués.
III. DOMAINE D ‘ ACTION
La raison pour laquelle les pare-feu sont filtrés est la suivante :
Le filtre est basé sur le numéro de protocole, l’adresse IP source/usage, le port source/fin et la direction du message qui sont transportés par la couche IP dans le paquet. En mode pare-feu transparent, il peut également être filtré en fonction de l’adresse MAC source/fin du message, trop de types, etc.
Le filtrage des paquets est appliqué dans les pare-feu, où les paquets de données qui doivent être transmis sont d’abord obtenus avec les informations d’en-tête puis comparés aux règles ACL définies, qui déterminent s’il faut faire suivre ou jeter le paquet sur la base d’une comparaison.
Pare-feu de filtre de paquet
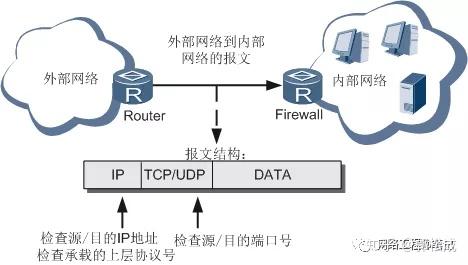
Prise en charge des périphériques pour le filtrage des pare-feu
Filtre IP commun : Firewall vérifie et filtre le message en fonction de la liste de contrôle d’accès ACL. Firewall vérifie l’adresse IP source/ destination, le numéro de port source/usage, le numéro de type de protocole du message, permet le passage du message admissible selon la liste de contrôle d’accès et rejette les messages qui ne correspondent pas à la condition. Firewall vérifie les sources d’information sont en en-têtes IP, TCP ou UDP.
Filtrage de deuxième niveau : Un pare-feu transparent peut vérifier et filtrer un rapport de deuxième niveau basé sur la liste de contrôle d’accès ACL. Le pare-feu vérifie la source/le but du message, MAC ou les champs trop-types qui permettent le passage selon la liste de contrôle d’accès et rejette les messages qui ne répondent pas aux exigences correspondantes.
Filtre de sous-rapport : Le filtre de paquet fournit une prise en charge pour le filtrage de détection des sous-fichiers. La paroi de filtrage de paquet identifiera le type de message, par exemple un rapport de non-séparation, une copie du premier film, une fonction de suivi, qui filtre tous les types de papier. Pour la première pièce, l’équipement correspond à la règle ACL avec trois couches d’information et quatre couches d’information, et si elle est passée, enregistre l’état de la première pièce, créant une table correspondante pour les sous-sections suivantes. Lorsque le sous-élément de suivi arrive, le pare-feu ne correspond plus aux règles ACL, mais les fait suivre sur la base des résultats de correspondance ACL de la première sous-filtration. De plus, pour les rapports qui ne correspondent pas aux règles ACL, le pare-feu peut également configurer le traitement par défaut.
IV. LUTTE CONTRE LES ÉTATS
Le paquet filtre le pare-feu statique et les problèmes actuels sont les suivants:
Certaines configurations de la politique de sécurité ne peuvent être prévues pour les protocoles multicanaux d’application (par exemple FTP, SIP, etc.).
Il n’est pas possible de détecter certaines attaques à partir des couches de transmission et d’application (par exemple TCP SYN, Java Applets).
Impossible d’identifier les fausses perceptions de la CIG à partir des réseaux, il est impossible d’éviter les attaques malveillantes de la part des CIG.
Pour les connexions TCP, les deux premières soumissions doivent être SYN et les premiers paquets TCP qui ne sont pas SYN seront rejetés. Ainsi, lorsque l’équipement est ajouté pour la première fois au réseau, les paquets non-premiers des liens TCP originaux sont rejetés pendant que des pare-feu nouvellement ajoutés sont ajoutés, ce qui interrompreait les connexions existantes.
Ainsi, le concept d’un pare-feu d’état – ASPF (Application Special Packet Filter) est proposé.
Essais de protocole des couches d’application, y compris FTP, HTTP, SMTP, RTSP, H.323 (Q.931, H.245 et RTP/RTCP);
Tests de protocole de transfert des couches, y compris les tests TCP et UDP, c’est-à-dire les tests universels TCP/UDP.
Fonction ASPF
Les principales fonctions de l’ASPF sont les suivantes :
Permet de vérifier les informations du protocole de couche d’application, comme le type et le numéro de port du message, et surveille l’état du protocole de couche d’application basé sur l’interface. Pour toutes les connexions, chaque information de connexion sera maintenue par ASPF et utilisée dynamiquement pour déterminer si les paquets de données sont autorisés dans un réseau interne par des pare-feu afin d’éviter toute intrusion malveillante.
• La capacité de détecter les informations du protocole des couches de transmission (c.-à-d. tests TCP/UDP génériques) et d’accéder au réseau interne par le biais de pare-feu basés sur les décisions de source, destination et port TCP ou UDP.
Les autres fonctions de l’ASPF sont les suivantes :
L’ASPF filtre non seulement les informations selon l’état de la connexion, mais surveille également le contenu des applications et fournit une fonction Java Blocing pour les sites indignes de confiance qui protège les réseaux des Applets Java nuisibles.
Teste le rapport initial du lien TCP pour voir s’il est SYN ou non, et décide de le jeter selon la configuration actuelle.
Prise en charge de la détection d’erreurs ICMP. Les messages d’erreur ICMP normaux contiennent des informations pertinentes sur la connexion correspondante à cet article, qui correspond à la connexion. Si la correspondance échoue, décider si vous devez rejeter la soumission ICMP selon la configuration actuelle.
En travaillant ensemble à la limite du réseau, l’ASPF et les pare-feu de filtrage de paquets peuvent fournir une stratégie de sécurité plus complète et axée sur la demande pour les réseaux internes d’entreprise.
Concepts de base du CSAF
Blocage Java
Java Blocing est un blocage du programme Java Applets qui est transmis via HTTP. Lorsque Java Blocing est configuré, la commande de requête envoyée par l’utilisateur pour essayer d’accéder aux Applets Java sur la page Web sera bloquée.
Accords à canaux uniques et multicanaux
Protocole monocanal : Un seul canal est impliqué dans l’interaction de données, par exemple SMTP, HTTP, pendant tout le processus, de la création à la suppression d’une session.
Protocoles multicanaux : contient un canal de contrôle et plusieurs autres contrôles ou canaux de données, c’est-à-dire que l’interaction des informations contrôlées et la transmission des données sont effectuées sur différents corridors tels que FTP, RTSP.
Fondements de détection du protocole de couche d’application
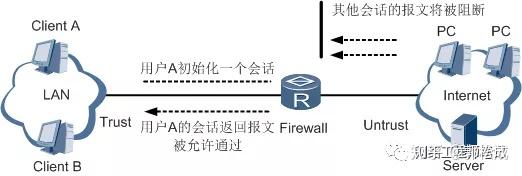
Comme le montre la figure, pour protéger un réseau interne, les listes de contrôle d’accès devront normalement être configurées sur un routeur pour permettre l’accès au réseau externe par l’hôte de l’intranet tout en refusant l’accès au réseau interne. Cependant, les listes de contrôle d’accès filtrent les messages retournés après que l’utilisateur a commencé la connexion et donc la connexion n’a pas pu être correctement établie.
Une fois le protocole de calque d’application configuré sur l’appareil, ASPF peut détecter chaque session de niveau d’application et créer une tabulation d’état et une liste de contrôle d’accès temporaire (liste de contrôle d’accès temporaire, TACL) :
1. La table d’état a été créée lorsque le premier message sortant est détecté par l’ASPF pour maintenir l’état d’une session à un moment donné et détecter la conversion correcte de la session.
Un calendrier de la liste de contrôle d’accès temporaire est créé en même temps qu’un élément de table d’état est créé et supprimé après la session, ce qui correspond à une extension de l’entrée de permis ACL. TACL est utilisé principalement pour correspondre à tous les retours dans une session et peut créer un canal de retour temporaire pour les retours d’une application sur l’interface externe du pare-feu.
Voici un exemple du processus de détection du protocole multicanaux par couche d’application à l’aide des tests FTP.
Schéma du processus d’essai FTP
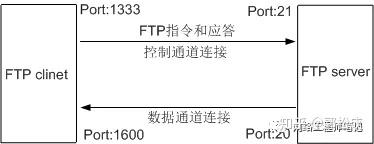
Comme le montre la figure, les connexions FTP sont créées comme suit : En supposant que FTP se connecte au port 21 du serveur FTP au port 1333, il est convenu par consultation que le port 20 du serviceur FTP initie une connexion de canal de données au port 1600 du client FTP et que le transfert de données est supprimé dans le temps ou après achèvement.
Le FTP détecte le traitement suivant pendant la connexion FTP à enlever:
1. Vérifie les messages IP envoyés hors de l’interface et les confirme comme FTP basé sur TCP.
Vérifiez les numéros de port pour confirmer la connexion en tant que lien de contrôle et créez TACL et tables d’état pour les retours.
3. Vérifiez les messages de connexion de contrôle FTP, interprètez la commande FTP et mettez à jour les entrées de table d’état selon les instructions. Si vous incluez un canal de données pour créer des instructions, créez TACL pour les connexions de données; aucune détection d’état n’est effectuée pour les liens de données.
4. Pour les déclarations, des vérifications de concordance sont effectuées selon le type d’entente et détermineront si une présentation est autorisée ou non conformément au tableau de situation de l’entente respective et de la LCAP.
5. Le tableau d’état et le TACL sont supprimés lorsque la connexion FTP est supprimée.
Un protocole d’application à un seul canal (par exemple SMTP, HTTP) est plus simple à détecter et TACL est créé lorsqu’une connexion est lancée, avec la suppression du lien.
Fondements de détection du protocole de transfert
La détection générique TCP/UDP est un test général TCP/UDP qui, contrairement aux tests de protocole au niveau de l’application, est effectué sur les informations transmises depuis la couche de message, comme la source, l’adresse de destination et le numéro de port. Les rapports retournés seront bloqués. Pour les applications multicanaux comme FTP, H. 323, les connexions de données ne peuvent être établies sans la configuration directe de la détection TCP sans une inspection au niveau de l’application.
V. LE BLACKLOCK
La liste noire est une façon de filtrer le message en fonction de son VPN source et de son adresse IP source. Par rapport à ACL, parce que la correspondance sur le champ est simple, les filtres peuvent être obtenus à très grande vitesse afin que les messages envoyés depuis une adresse IP donnée soient efficacement protégés, tandis que les utilisateurs sont pris en charge dans la configuration statique des listes noires et des pare-feu générant dynamiquement des listes noires.
Comme le montre la figure, l’adresse IP de l’utilisateur B est déjà sur la liste noire et tous les messages envoyés par l’utilisateur B seront rejetés par des pare-feu.
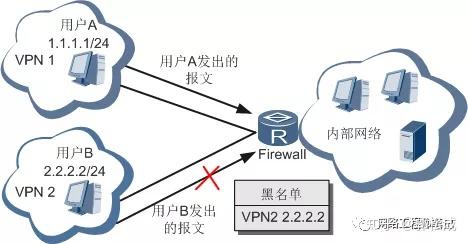
Prise en charge des périphériques pour listes noires
En plus de la configuration statique des listes noires, lorsqu ‘ une adresse IP spécifique est trouvée par le périphérique actif dans une attaque à balayage ou une attaque à balayage de port, l ‘ adresse IP de l ‘ attaquant est automatiquement insérée dans une liste noire. Si la liste noire a été activée, tout message de cette adresse IP peut être filtré pendant une certaine période par la suite.
Les utilisateurs peuvent configurer l’âge des listes noires statiques et dynamiques.
Que le paquet de données sur liste noire soit autorisé ou non en vertu des règles ACL, le pare-feu rejette ces paquets de données.
Les utilisateurs peuvent exporter des informations de configuration de la liste noire vers un fichier ou importer des profils de liste noire via un fichier.
VI. Liste blanche
L’hôte qui ajoute une liste blanche au pare-feu ne sera pas ajouté à la liste noire dynamique et statique, en utilisant les adresses VPN source et IP comme élément de liste blanche. La liste blanche est principalement utilisée dans les situations où des messages commerciaux légitimes provenant de certains appareils du réseau ont des attaques de numérisation IP et des analyses port des caractéristiques d’attaque, empêchant le périphérique particulier d’être blacklisté par les pare-feu.
La liste blanche est statique seulement.
Caractéristiques de la Liste blanche
Si l’utilisateur ajoute les adresses VPN et IP d’un hôte à la Liste blanche, le pare-feu ne mène pas d’attaque de numérisation IP sur les messages de l’hôte ou les attaques de balayage de port, ni ne génère une liste noire dynamique de son adresse IP, ni ne permet aux utilisateurs d’ajouter des hôtes de listes blanches à des listes noires statiques.
Prise en charge du périphérique pour la liste blanche
Si tel est le cas, l’appareil ne procède pas à une vérification de l’attaque par balayage IP et de l’attaque par balayage port sur cet article ou ne génère pas de liste noire dynamique pour l’IP source, mais d’autres filtres de sécurité tels que le filtrage des paquets ACL, ASPF, les statistiques du trafic et la surveillance sont toujours nécessaires pour obtenir un filtrage maximal de sécurité des pare-feu.
Les utilisateurs peuvent configurer l’âge de la liste blanche.
L’utilisateur peut exporter des informations de configuration de liste blanche dans un fichier, ou importer des profils de liste blanche à partir d’un fichier.
Carte des ports
Le protocole de couche d’application utilise habituellement un numéro de port connu pour la communication. La cartographie des ports permet aux utilisateurs de définir un nouvel ensemble de numéros de port pour différents protocoles de niveau d’application, et précise également la plage d’hôte qui utilise des ports inconnus.
La cartographie des ports n’est significative que lorsqu’elle est utilisée conjointement avec des fonctionnalités sensibles aux affaires telles que ASPF et NAT. Par exemple, les serveurs FTP internes sont disponibles via le port 2121 dans un réseau privé d’entreprise.
Puisque le numéro de port du message FTP est 21 par défaut, le serveur FTP ne pourra pas reconnaître le message de port 21 comme une application FTP. A cette occasion, une carte de port devra être utilisée pour cartographier le port 2121 dans un protocole FTP, et le serveur NAT transmettra le message de port 2121 comme message de protocole FTP au serveur FTP pour permettre l’accès au serveur FTP.
Prise en charge des périphériques pour la cartographie de port
La prise en charge du portage est assurée par ACL, qui ne se produit que lorsque l’image de port correspond à un message d’une ACL. L’image de port utilise la base ACL (Nos 2000-2999).
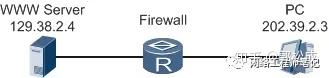
Comme le montre la figure, l’accès externe au PC aux serveurs WWW internes via Router (numéro de port 8080) et lorsque les messages PC externes passent par Router, un message ACL frappé sera utilisé pour la cartographie de port, qui ne peut être faite que par Router avec une adresse de 129.38.2.4.
Carte des ports
VIII. Préparation aux attaques
Types de cyberattaques
Les cyberattaques se divisent généralement en trois grandes catégories : attaques de déni de service, attaques espionnes scannées et déformations :
1. Attaques de type déni de service
Les attaques DoS de type service déni sont l’utilisation d’un grand nombre de paquets de données pour attaquer les systèmes, les empêchant d’accepter des requêtes normales des utilisateurs ou suspendant l’hôte pour un travail irrégulier.
La différence entre les attaques de déni de service et d’autres types d’attaque est que les attaquants ne cherchent pas à accéder aux réseaux internes, mais empêchent plutôt les utilisateurs légitimes d’accéder aux ressources ou aux pare-feu.
2 Scan et attaques d’espion
Les attaques par balayage et par espion sont des systèmes qui utilisent des scans ping (y compris les ICMP et TCP) pour identifier la survie sur le réseau, identifiant ainsi avec précision les cibles potentielles.
En scannant et en espionnant, les assaillants peuvent obtenir un aperçu du type de services fournis par le système cible en vue d’une nouvelle intrusion dans le système.
3. Attaques déformées
L’attaque des malformations est l’envoi de messages IP défectueux aux systèmes cibles, causant une panne dans le système cible lors de la gestion de tels paquets IP, entraînant des dommages au système cible. Les principales déformations sont Ping of Death, Tedrop, etc.
Soutien matériel pour la prévention des attaques:
Terre, attaque.
Les attaques terrestres sont le réglage des adresses IP source et destination pour le paquet SYN de TCP. Cela se traduira par l’envoi de son propre message SYN-ACK par l’ordinateur cible, ainsi que par la transmission d’un message ACK à lui-même et la création d’une connexion vide, chacun d’eux restant ouvert jusqu’à ce qu’il soit supplémentaire.
Terre, plan d’attaque.
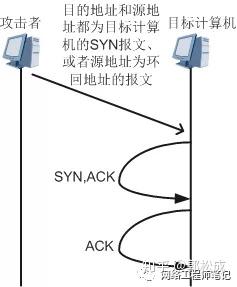
Différents types d’hôtes réagissent aux attaques de Land, beaucoup d’hôtes UNIX s’effondrent et Windows NT principales opportunités deviennent extrêmement lents.
Attaque de Schtroumpf
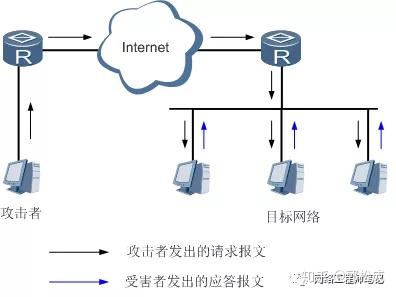
Une simple attaque de Schtroumpf est utilisée pour attaquer un réseau. L’agresseur envoie le message de demande de réponse ICMP au réseau cible, qui a l’adresse ciblée indiquée à l’adresse de diffusion du réseau cible, afin que tous les hôtes du réseau cible répondent à cette requête et causent la congestion web.
Graphique d’attaque simple de Schtroumpf
Les attaques avancées de Schtroumpf sont utilisées principalement pour attaquer l’hôte cible. L’agresseur envoie une demande de réponse ICMP au réseau où se trouve l’hôte cible, et l’adresse source du message est définie à l’adresse de l’hôte cible afin que toutes les réponses soient envoyées à l’hôte cible. En fin de compte, l’hôte cible est lent à traiter ou même à s’effondrer.
Graphique avancé d’attaque de Schtroumpf
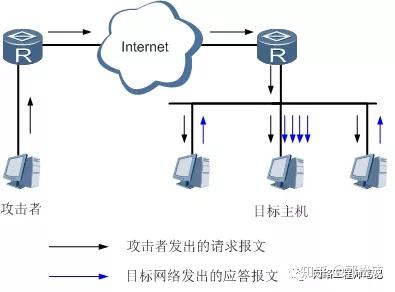
Les attaques de Schtroumpf prennent une certaine quantité de trafic et de durée pour délivrer le message afin de constituer réellement une attaque. En théorie, plus le réseau cible est hébergé, plus l’impact de l’attaque est grand.
Attaque de WinNuke
NetBIOS est une interface d’accès de base aux ressources Web qui est largement utilisée pour le partage de fichiers, le partage d’impressions, la communication interprocessus (IPC) et l’échange de données entre différents systèmes d’exploitation.
Afin d’atteindre NetBIOS sur la pile de protocole TCP/IP, le RFC établit une série de critères interactifs et plusieurs ports TCP/UDP couramment utilisés comme suit.
139: Port TCP pour le service de session NetBIOS.
137: port UDP pour les services de noms NetBIOS.
136: Port UDP du service de communication des données NetBIOS.
Le système d’exploitation Windows a atteint NetBIOS par rapport à la fonctionnalité TCP/IP et a ouvert le port 139.
L’attaque de WinNuke était une échappatoire dans le système d’exploitation Windows, envoyant des messages à ce port 139 avec des données TCP à l’extérieur, mais contrairement à ceux qui transportent normalement des données OOB, leurs champs pointeurs ne correspondent pas à l’emplacement réel des données, c’est-à-dire le chevauchement et lorsque Windows opère ces données s’effondrent.
SYN Attaque d’inondation
Les attaques de SYN Flood utilisent une faille dans TCP trois poignées de main pour lancer une attaque sur l’ordinateur cible. L’agresseur envoie une demande de connexion TCP (SYN) à l’ordinateur cible, et ne répond pas au rapport SYN-ACK que la cible est retournée. Si l’ordinateur cible ne reçoit pas de réponse de l’ACK des attaquants, il attendra que la moitié de la connexion soit libérée.
Icône semi-connecteur
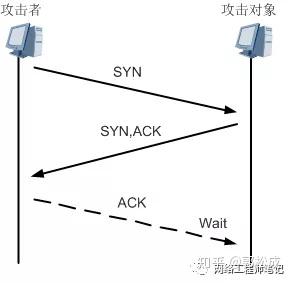
Ainsi, les attaquants envoient un grand nombre de messages TCP SYN qui permettent à l’ordinateur cible de générer un grand nombre de connexions semi-connectées, ce qui le force à gaspiller ses vastes ressources sur ces liaisons semi-connectées. Une fois que l’ordinateur cible a épuisé ses ressources, il y a des situations où l’ordinateur cible est très lent et les utilisateurs normaux ne peuvent pas y accéder.
Les attaquants peuvent également forger un journal SYN avec une adresse fausse ou inexistante et lancer une attaque sur l’ordinateur cible.
Inondation ICMP Attaque !
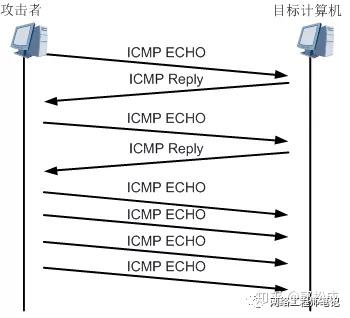
Normalement, les administrateurs de réseau utilisent des programmes PING pour surveiller et dépanner les réseaux, comme suit :
L’ordinateur source envoie une demande de réponse ICMP (ICMP ECHO) à l’ordinateur destinataire.
2. Une fois que l ‘ ordinateur a reçu une réponse de la CIG à la demande, il répond à une réponse de la CIG (Réponse Echo).
Ce processus doit être géré par le CPU et, dans certains cas, il peut consommer des ressources importantes.
Si les attaquants envoient un grand nombre de messages ECHO ICMP à l’ordinateur cible (qui a généré l’inondation de la ICMP), l’ordinateur cible est occupé à traiter ces soumissions ECHO et ne peut pas continuer avec d’autres rapports de données.
Carte d’attaque des inondations de la CIG
Inondation UDP Attaque !
La raison d’être de l’attaque contre les inondations du PPU est semblable à celle de l’attaque contre les inondations du PMI, où les agresseurs n’ont pas pu continuer à communiquer normalement en envoyant un grand nombre de messages PDU à l’ordinateur cible, ce qui a rendu l’ordinateur cible trop occupé à traiter ces rapports PPU.
Les attaquants de balayage et de numérisation des adresses utilisent des outils de balayage pour détecter les adresses et les ports cibles, qui répondent à ces détections, en les utilisant comme base pour déterminer quels systèmes cibles sont vivants et connectés au réseau, quels portails sont ouverts ou fermés.
Ping de l’attaque de la mort
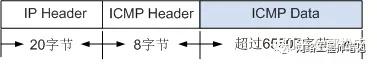
Ping of Death est une attaque contre le système en utilisant un journal ICMP surdimensionné.
La longueur du message IP est de 16 bits, ce qui indique que la longueur maximale d’une soumission IP est de 65535. Pour les réponses ICMP aux demandes d’information, si les données sont supérieures à 65507, elle fait des données ICMP + Longueur de la tête IP (20) + Longueur de la tête ICMP (8) > 65535. Pour certains pare-feu ou systèmes, après avoir reçu un message de ce type, l ‘ échec du traitement entraîne l ‘ effondrement, la mort ou le redémarrage d ‘ un système.
ICMP Diagramme de super-haute visibilité
Attaque de grande envergure de l’ICMP
Comme pour la ping of death, le Large-ICMP est une attaque contre le système en utilisant un grand journal ICMP qui, contrairement à la ping of death, ne dépasse pas la longueur maximale du papier IP 65535 mais provoque également des fissures dans certains systèmes d’exploitation.
La longueur maximale des messages ICMP autorisés à passer doit être configurée sur le pare-feu.
Attaque impossible à atteindre par la CIG
Certains systèmes sont considérés comme inaccessibles pour les messages ultérieurs envoyés à cette destination dès réception d’une ICMP qui n’est pas disponible sur Internet (champ de type de fichier 3 et champ de code 0) ou sur un ordinateur central (champ de type de courrier 3 et champ de code 1).
Graphique d’attaques inaccessibles ICMP
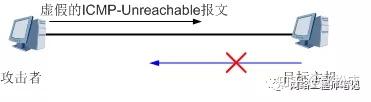
Grâce à ce mécanisme, les attaquants ont envoyé de faux messages non accessibles ICMP à l’hôte cible, perturbant l’information sur la route de l’hôte cible et influençant sa transmission.
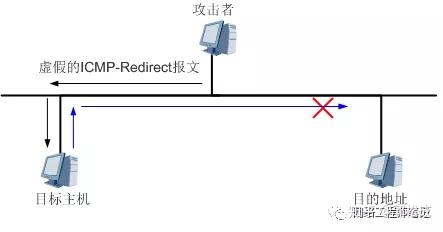
Attaque de la CIG-rédirection
L’attaque ICMP-Redirect est similaire à l’attaque ICMP-Injoignable.
Le périphérique réseau peut envoyer un message de redirection ICMP à l’hôte du même sous-net, demandant à l’hôte de modifier l’itinéraire.
En utilisant ce principe, les attaquants ont envoyé de faux messages redirectionnels sur le web à l’hôte cible d’un autre réseau afin de changer le tracé de l’hôte cible.
L ‘ attaque a eu des répercussions sur l ‘ information relative à la route de l ‘ ordinateur central de la cible et a affecté la transmission des messages.
Graphique d’attaques indirectes ICMP
Attaque de défragment IP
Plusieurs champs du papier IP sont pertinents pour le segment : les bits DF (Ne pas fragmenter), MF, Fragment Ofset et Length.
Si les valeurs des champs susmentionnés sont contradictoires et que l’équipement n’est pas manipulé correctement, il peut avoir un impact sur l’équipement ou même être paralysé.
La position DF est réglée, tandis que la position MF est réglée en même temps ou le Fragment Ofset n’est pas zéro.
Position DF 0 et longueur de l’offset+ du fragment > 65535。
En outre, comme la présentation d’une caractéristique alourdirait le fardeau de l’équipement tamponné et de restructuration à cette fin, il faudrait la supprimer directement dans la sous-section du dispositif lui-même.
Attaque de la goutte d’eau
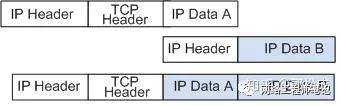
Dans l’en-tête du rapport IP, il y a un champ offset (OFFSET) et un sous-script (MF), ce qui indique que le message IP est un sous-ensemble d’un paquet IP important, où l’écart indique l’emplacement de ce clip dans l’ensemble du paquet IP. Le récepteur peut restaurer le paquet IP en se basant sur ces informations à partir de l’en-tête.
Par exemple, lorsqu’un document plus gros est transmis sur la chaîne MTU plus petite, il est divisé en deux documents IP qui seront assemblés à la fin de la destination et retournés au message IP original.
Profil de sous-section normal
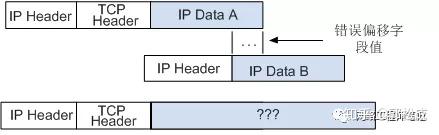
Si un attaquant brise cette situation normale et place le champ de déviation à des valeurs incorrectes, c’est-à-dire qu’il peut y avoir des chevauchements ou des ruptures. Certains composures TCP/IP s’effondrent lorsqu’ils reçoivent un faux sous-segment comme ceux-ci avec des écarts qui se chevauchent, ce que l’on appelle les attaques Teardrop.
Graphique d’attaque Teardrop
Une attaque fragrante.
La raison d’être de l’attaque Fraggle est semblable à celle de l’attaque Schtroumpf, cependant, l’attaque Fraggle a envoyé un UDP plutôt qu’un ICMP. Parce qu’elle a envoyé un message UDP, l’attaque Fraggle pourrait passer par certains pare-feu qui ont empêché le rapport ICMP d’entrer.
La raison d’être de l’attaque Fraggle est que le port 7 (ECHO) et le port 19 (Chargen) répondront à la fois lorsqu’ils recevront un message UDP.
Dès réception du message, le port UDP 7 répondra à ce qui est reçu comme ICMP Echo Reply.
Dès réception du message, le port UDP 19 produit un flux.
Les deux ports UDP génèrent un grand nombre de réponses, en éloignant la bande passante du réseau.
L’attaquant peut envoyer des messages UDP au réseau dans lequel l’hôte cible est situé avec une adresse qui provient d’une attaque sur l’hôte, ou une adresse de radiodiffusion ou sous-réseau où il se trouve. Le numéro de port final est 7 (ECHO) ou 19 (Chargen). Chaque système qui active cette fonctionnalité envoie un message de réponse à l’hôte touché, générant ainsi un trafic important et causant une congestion dans le réseau ou l’effondrement de l’hôte.
Si ces fonctionnalités ne sont pas activées par le ou les hôtes du réseau cible hôte, ils généreront un message ICMP qui est inaccessible et consomme toujours de la bande passante. Le port source peut également être changé au port 19 (Chargen), avec un port destination de 7 (ECHO), qui produit automatiquement des réponses plus nocives.
Attaque de trace
Tracert est une source de retour des heures supplémentaires ICMP sur TTL (Time To Live) et un port ICMP inatteignable revient à l’arrivée pour trouver le chemin vers la destination.
Les attaquants peuvent utiliser Tracert pour pénétrer dans la structure du réseau. C’est potentiellement dangereux pour le réseau.
Attaque de journaux TCP malformés
La soumission de TCP est le résultat d’une erreur dans le traitement du lien TCP du destinataire en malversant délibérément six marqueurs dans la tête de TCP pour atteindre le but de l’attaque.
IX. Statistiques des flux et suivi
Le pare-feu surveille non seulement les flux de données, mais aussi le lancement des connexions entre réseaux internes et externes, qui sont fortement calculés et analysés statistiquement. L’analyse statistique du pare-feu peut être suivie d’une analyse post-analyse des informations log à travers un logiciel analytique spécialisé, d’une part, et le système pare-feu lui-même peut effectuer une partie de ses fonctions analytiques avec certaines propriétés en temps réel.
Par exemple, une analyse de la question de savoir si les connexions TCP/UDP lancées par un réseau externe ont dépassé le seuil fixé peut déterminer s’il est nécessaire de limiter le lancement de nouveaux liens dans cette direction ou de restreindre l’ouverture de nouvelles connexions à une adresse IP d’un réseau interne.
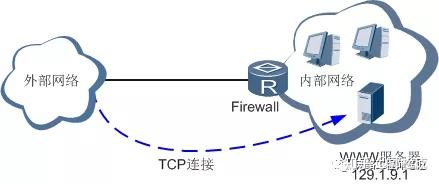
Ce chiffre est un exemple typique de l’application des pare-feu, où un réseau externe est activé avec une fonction d’analyse IP au réseau interne. Si les connexions TCP initiées par le réseau extérieur au serveur Web 129.1.9.1 dépassent le seuil établi, il limitera la capacité du réseau externe à lancer de nouvelles connexions au serveur jusqu’à ce que le nombre tombe dans la plage normale.
Nombre de connexions TCP extra-spécifiques
Les statistiques de flux et les méthodes de surveillance financées par l’équipement sont les suivantes:
Statistiques et suivi de la circulation au niveau du système
Les statistiques et la surveillance du trafic au niveau du système prennent effet pour tous les flux de données interdomaines sécurisés à l’échelle du système avec fonctionnalité pare-feu, c’est-à-dire que les appareils mesurent le nombre de connexions entre ICMP, TCP, UDP, etc. dans tous les domaines de sécurité.
Statistiques et surveillance du trafic sur la base des zones de sécurité
Selon les statistiques de flux et la surveillance d’une zone sécuritaire, les flux de données entre cette zone et d’autres zones sécuritaires sont efficaces, c’est-à-dire que l’équipement mesurera le nombre total de TCP, de PDU, etc. reliés à cette zone sécuritaire et à toutes les autres zones sûres. Lorsque le nombre total de connexions établies entre cette zone de sécurité et toutes les autres zones de sécurité ou dans une direction dépasse le seuil assigné, l’appareil prendra des mesures pour limiter les numéros de connexion jusqu’à ce que le nombre de connexions tombe sous le seuil.
Statistiques du trafic et surveillance basées sur les adresses IP
Sur la base des statistiques de flux et du suivi des adresses IP, une connexion TCP/UDP est utilisée pour mesurer et surveiller une adresse IP unique dans une zone de sécurité. En analysant si le nombre total de connexions TCP ou UDP reçues par l’adresse IP source ou par l’adresse de destination dépasse le seuil établi, on peut déterminer s’il est nécessaire de limiter le lancement de nouveaux liens dans cette direction afin d’éviter les attaques malveillantes sur des systèmes ou des dénis de services du fait que le système est trop occupé.
Lorsque la connexion TCP/UDP tombe sous le seuil, l’adresse IP source ou l’adresse de destination peut être redémarrée ou acceptée pour les connexions TCP ou UDP.
Registres pare-feu
Les pare-feu peuvent enregistrer le mouvement et l’état des pare-feu en temps réel (par exemple, certaines mesures de pare-feu, détection d’une cyberattaque, etc.) et enregistrer les informations dans les journaux.
L’analyse et l’archivage du contenu du journal permettent aux gestionnaires de vérifier les trous de sécurité du pare-feu, lorsque quelqu’un tente de briser les tactiques de sécurité, les types de cyberattaques et les enregistrements en temps réel peuvent également être utilisés pour détecter les incursions continues.
La fonction de log du pare-feu peut être configurée lorsque les mouvements et l’état du pare-feu doivent être enregistrés afin de vérifier les lacunes en matière de sécurité, détecter les cyberattaques et les intrusions.
Prise en charge des périphériques pour les journaux pare-feu
Journal de la liste noire
Lorsqu’un balayage d’adresse, un scan de port, etc. est détecté, l’appareil génère dynamiquement un journal de liste noire lorsqu’il est activé pour le faire.
Les listes noires qui sont ajoutées manuellement génèrent également des journaux de liste noire.
Une liste noire dynamique, une liste noire statique qui est ajoutée manuellement à la liste, produit un journal de liste dé-black après un temps de vieillissement.
Journal des attaques
Lorsque l’équipement est trouvé pour différents types d’attaque, il produit un journal d’attaque qui enregistre le type et les paramètres de l’attaque.
Registre de contrôle du débit
L’appareil génère des journaux de surveillance du trafic lorsque le nombre de conversations dans l’ensemble du système, et les accès régionaux, dépasse le plafond du seuil de connectivité assigné, et lorsque le nombre de sessions tombe sous la limite inférieure du seuil de connexion configuré, l’appareil produit des journaux de récupération de flux.
Journal des flux
Le journal de flux du périphérique est utilisé pour encapsuler les informations du journal de flux et les envoyer au serveur de log dans une session vieillissante.
XI. FALLS VIOLENTS
Les petits réseaux privés se sont développés ces dernières années et sont généralement destinés aux petites entreprises.
Il est absolument nécessaire de prendre des précautions en matière de sécurité.
Sur le plan financier, il n’est pas possible de se doter d’un dispositif de sécurité spécialisé.
Le support de l’équipement est logiquement divisé en pare-feu virtuel, qui fournissent une sécurité indépendante à un certain nombre de petits réseaux privés.
Chaque pare-feu virtuel est une combinaison d’exemples VPN-Installation, de sécurité. Il fournit un plan de transfert de route privé et des services de sécurité pour les utilisateurs du pare-feu virtuel
Exemple de VPN
L’exemple VPN fournit une route VPN séparée pour les utilisateurs de pare-feu virtuel, correspondant au pare-feu virtuel.
Exemples de sécurité
Les exemples de sécurité fournissent des services de sécurité distincts pour les utilisateurs de pare-feu virtuel, qui correspondent au pare-feu virtuel. Ces exemples de sécurité comprennent des interfaces privées, des zones sécurisées, des espaces sécurisés, des règles ACL et NAT, ainsi que des services de sécurité privés tels que les listes noires, le filtrage des paquets, les statistiques du trafic et la surveillance, la prévention des attaques, l’ASPF et NAT pour les utilisateurs de pare-feu virtuels.
XII. Système de protection contre les pare-feu
L’équipement pare-feu est un point unique à travers lequel toutes les informations doivent passer, et tout flux d’informations qui se décompose en cas de défaillance.
Pour résoudre ce problème, deux pare-feu peuvent être utilisés pour la redondance. L’un est le pare-feu principal (Master) et l’autre le pare-feu de secours (Backup).
Pare-feu.
Le pare-feu est un pare-feu ultramoderne, qui ne vérifie que le premier paquet du flux de session et génère dynamiquement un calendrier de session. Pour chaque connexion de session générée dynamiquement, il y a une table de session sur le pare-feu qui lui correspond. Les informations sur l ‘ état de la session de l ‘ utilisateur sont enregistrées dans l ‘ élément de liste des sessions, et les messages suivants (y compris les retours) ne peuvent passer par le pare-feu que s ‘ ils correspondent au calendrier des sessions.
Carte du site de l’équipe principale de Firewall
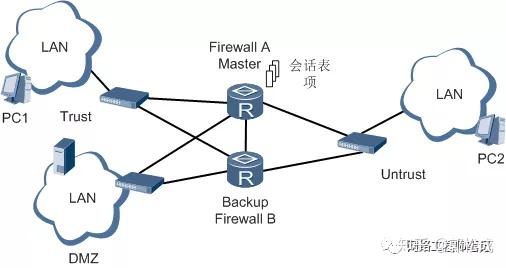
Comme le montre la figure, Firewall A a créé de nombreuses tables de session dynamiques à bord en tant qu’équipement principal et entreprend toutes les tâches de transfert de données; tandis que Firewall B est back-up sans aucun flux de trafic.
Si Firewall A échoue ou que le lien associé est compromis, Firewall B passera à un nouveau maître et commencera à exécuter des tâches de transmission.
Si l’élément de liste de sessions n’est pas sauvegardé sur Firewall B avant le changement d’état, toutes les sessions précédemment passées Firewall A ne pourront pas communiquer parce qu’elles ne correspondent pas à l’horaire Firewall B et provoqueront des perturbations commerciales.
Pour obtenir une défaillance du pare-feu Master, il est possible de remplacer en douceur le pare-feu Backup, avec des sauvegardes en temps réel de tables de session et des informations d’état entre les murs Master et Backup ; les maîtres actuels du pare-feu peuvent obtenir des sauvegardes et une synchronisation grâce aux mécanismes HSB pour la table conversationnelle et l’information d’état entre les pare-feu Master et Backup.
Exigences relatives à l’état du réseau de pare-feu
Message pare-feu pas cohérent carte de chemin
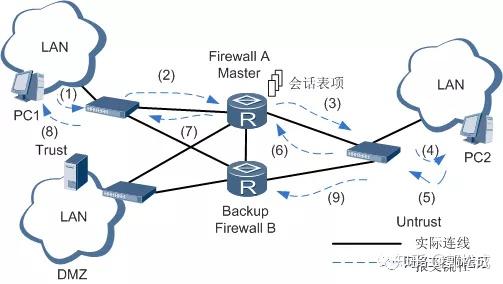
L’état du VRRP du pare-feu doit être cohérent, ce qui signifie que plusieurs interfaces sur le pare-feu et connectées à chaque zone de sécurité sont dans le même état, c’est-à-dire à l’état primaire ou en veille.
En supposant que l’état du PARV du Pare-feu A et du Pare-feu B est cohérent, c’est-à-dire que toutes les interfaces de Pare-feu A sont primaires et toutes les interfaces de Pare-feu B sont en attente. À ce moment, PC1 dans la région Trust a accès au PC2 dans la zone Untrust avec des voies de transmission de (1)-(2)-(3)-(4). Lorsque les rapports de retour PC2 arrivent par (5)-(6)-(7)-(8)/Firewall A, le retour et la communication sont effectués en douceur en appariement avec les éléments du calendrier des séances.
En supposant que l’état VRRP du Pare-feu A et du Pare-feu B n’est pas cohérent, p. ex. l’interface entre le Pare-feu B et la zone Trust est en attente, mais l’interface avec la région Untrust est principalement utilisée, PC1 générera dynamiquement des tables de session sur Firewall A après avoir atteint PC2 via Firewall A. PC2 retourne par route (5)-(9). À l’heure actuelle, puisqu’il n’existe pas de calendrier pour les flux de données correspondants sur Fairwall B, Firewall B abandonnera le papier sans autres règles de filtrage permettant le passage.
En outre, la liaison descendante vers le commutateur peut assurer sa fiabilité grâce au SmartLink du commutateur tout en veillant à ce que les liaisons descendantes échouent entre deux dispositifs de pare-feu au moyen d ‘ une liaison directe qui permettra le trafic correspondant à l ‘ extrémité opposée du pare-feu.
Remarque:
Les pare-feu ne supportent pas la sauvegarde à double chauffage des données de configuration de l’utilisateur, et les utilisateurs doivent assurer la cohérence dans la distribution des données sur les deux pare-feu.
• Les deux ensembles de sauvegarde doivent être identiques en taille, avec la même mémoire, CPU et configuration des fonctionnalités, sinon une sauvegarde complète ne peut pas être garantie.
La version logicielle des deux dispositifs de sauvegarde doit être cohérente.
L’interface de sauvegarde ne peut être identique à l’interface d’affaires du pare-feu et doit utiliser une interface de sauvegarde dédiée, qui n’est plus impliquée dans la transmission des données.
Le pare-feu principal sous le profil asymétrique de la route n’est pas pris en charge, et un seul flux doit passer par le même équipement.
La synchronisation des informations statistiques n’est pas prise en charge, mais seulement le maître de session pour TCP/UDP.
未经允许不得转载:萌萌Apprentissage » Cybersécurité -- pare-feu -- attaques cybernétiques courantes


 apprendre NMAP

