
 ">WeChat
Source de la procédure :Vue Zige La source du jeu. ul00.com
#程序改好爬取数据和存储csv 下一步解决匹配数据 工作地点和招聘人数
#新问题出现了直接调用 datalist写入数据是一条数据包括(网址 工资…)写到了一起
#添加header use-agent 已解决 下一步利用数据进行画图输出可视化数据
from bs4 import BeautifulSoup
# 正则表达式
import re
# 定制url,获取网页数据
import urllib.request,urllib.error
# 进行excel操作
import xlwt
# 进行数据库操作
import sqlite3
# 根据需求对输入的解析
from urllib import parse
from lxml import etree
import json
import requests
import csv
keyWord =input(« 请输入需要爬取的关键字: »)
word=parse.quote(keyWord)
newWord = parse.quote(word)
# jobData={}#每一个记录是一个列表,把二次获取到的网页存成字典格式
# jobList =[] #把上面获取到的信息放在列表中
#伪装爬取头部,以防止被网站禁止
headers={‘Host’:’search.51job.com’,
‘Upgrade-Insecure-Requests’:’1′,
‘User-Agent’:’Mozilla/5.0 (Windows NT 6.1) AppleWebKit/537.36 (KHTML, like Gecko)\
Chrome/63.0.3239.132 Safari/537.36′}
def main():
# 爬取网页
# url = « https://search.51job.com/list/090200,000000,0000,00,9,99, » + newWord + « ,2, » + str(pageNmb) + « .html »
# html = asskUrl(url) # imprimer (html) la liste de données = [ ] pour i en reng (1 1005) # ramper 1-2 pages url = « https://search.51job.com/list/000000,000000,0000,00,9,99, »+newWord+ »,2, »+str(i)+ ».html »
pagaLink=getLink(url)#crawling list page if len (pagaLink)=0: break for job in pagaLink: data=getaData (jobpage)#link for a detailed page
# Ouvrez le fichier Data_mining.csv et effectuez des opérations d’écriture #csvFile=open (« 51job1.csv », ‘a’, newline=’) scriber=csv.writer(csvfile) scriber.writeow (`link’, ‘job’, ‘support’,’company’,’experience’, ?? education’,’renshu’,) scribe.write (« job_name +theatect +,’data_time ‘,’money + ‘n’) #fwrite(),join(job_list) #Getdata # # savaData2DB (datalist, dbpath) #csv
# 获取网页信息
def getLink(url):
dataList=[]
#获取到源码
html = askUrl(url)
data = str(html)
# print(data)
find_info = re.findall(r’window.__SEARCH_RESULT__ = {(.*?)keywords’, data)
# print(find_info)
#拼接上少了的:keywords »: »找工作,求职,人才,招聘 »}这一部分
find_info = ‘{‘ + str(find_info[0]) + ‘mots clés’: « Rechercher un emploi, trouver un talent, recruter »} # print(find_info) # # convertir le contenu en format json json_data = json.loads (find_info) #print(json_data) pour i dans json_data [`engine_search_result’]: dataList.append(i[‘job_href’]) #print(jobList) # print(dataList) retourner dalist
# 二次获取到的链接页面解析
def getaData(jobpage):
data = []
jobHtml = askUrl(jobpage) #获取详情页面
# print(jobHtml)
soup = BeautifulSoup(jobHtml, « html.parser »)
# data.append(jobpage) jnames = soup.select(‘h1[title]#titre de la position #print(jnames)jname=jnames[0][« title »] # print(jname) # data.append(jname)
# Traitement #[0]) si str(monnaies[0])== »<forte></fort> »: argent = entretien »[0].string # data.append(money)
gnames = soupe.select(« .cname > # Le nom de l’entreprise est gname=gnames[0][« titre »] # data.append(gname)
# Liste d’expérience de travail1 = emploiMlisit[0][« title »].split(« ) jinyan = list1[1].strip() # data.append(jinyan)
lieu = list1[-1].strip()# Lieu d’affectation #data.append(lieu) #print(lieu)
xuli = list1[2].strip()#education#data.append(xuli)#print(xuli)#renshu=list1[3].strip() # Recrutements
# essayer: data.append(jobpage+ » « +jname+ » « +money+ » « +gname+ » « +jinyan+ » « +xuli) # sauf: # pass # print(renshu)
print(data) retourner les données
# 爬取网页
def askUrl(url):
# 模拟浏览器信息,想豆瓣服务器发送信息
headers = {
« User-Agent »: « Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/83.0.4103.116 Safari/537.36 »,
}
# 用户代理,告诉服务器,我们是什么类型的机器,浏览器(本质上是告诉浏览器我们可以接收什么水平的内容)
# Envoyer la requête de message = urllib.request. ReQuest (url, entêtes=heads) html = « » # capture anormale: # obtenir une réponse # réponse = urllib.request.urlopen (requête) # Accès au contenu web # html = respone.read().decode(« gbk ») #print(html) sauf urllib.error.URLError comme e: si haasattr(e, « code »): print(e.code) si Hasattr(e, « reson »): print(e.resson) html
Si __nom__ == ‘_main__’: main() # askUrl(« https://jobs.51job.com/chengdu-gxq/124561448.html?s=01&t= 0 ») imprimer
未经允许不得转载:萌萌Apprentissage » Python rampe 51 données d'emploi et stocke des fichiers csv


 Python lote pour extraire des images de moteurs de recherche
 Le mot de Python grimpant à 100 degrés.
 PythonTaiichi Taipei Intelligence artificielle Traitement graphique de Tensoflow
 Sélénium avec navigateur Tor en utilisant Python
 Je vais t'en chercher un nouveau, Shell.cloud.google en ligne.
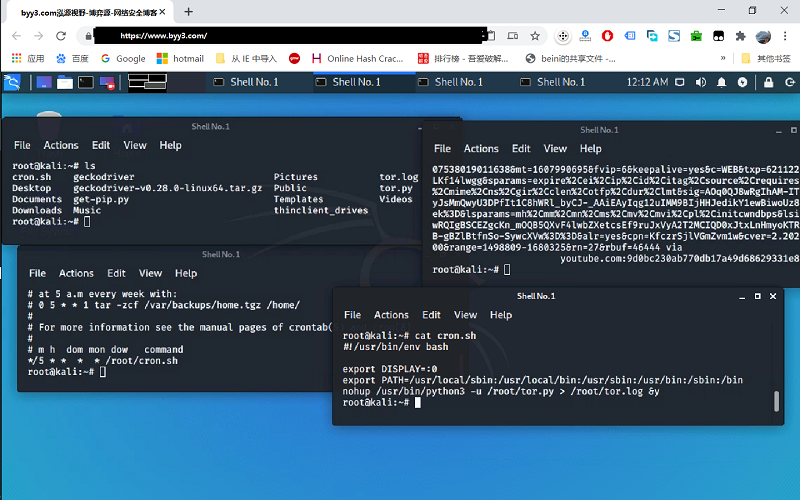 exécuter crontab avec python sélénium tor navigateur affichage dans linux
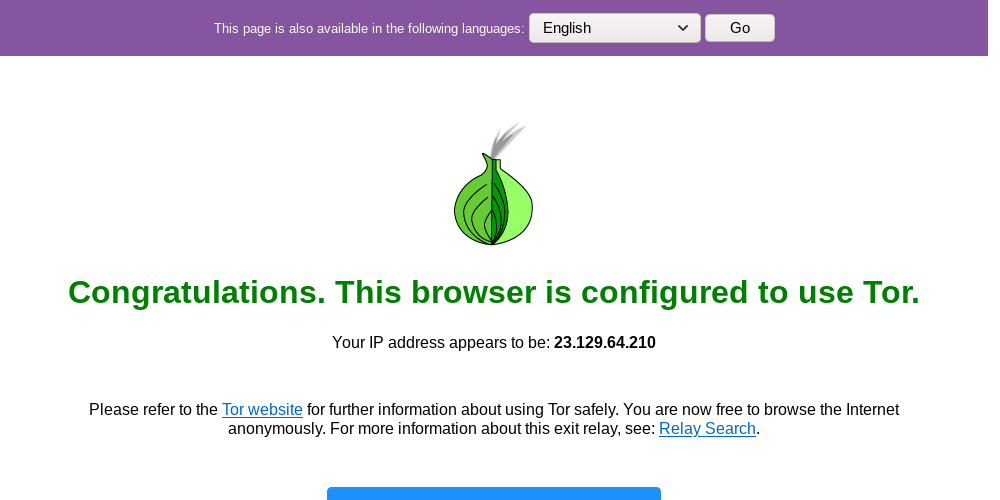 Environnement Lineux Utilisez python pour appeler la page Web du navigateur ter aléatoire

